IPsyO抽样偏差:从招募方式判断研究结论能推广到谁
IPsyO材料题中,有一类题型不考计算、不考概念定义,而是给出一段研究的招募方式,然后问「该结论能推广到谁」。这类题的本质是考查外部效度(external validity)——也就是抽样偏差(sampling bias)如何限制研究结论的适用范围。很多学生看到「随机」就以为可以推广到所有人,看到「志愿者」就一概否定,这种粗糙的判断方式在IPsyO的选项设计中很容易踩坑。
本文从招募方式出发,用两个结构对称但结论方向不同的对比教学案例,展示如何判断研究结论的推广边界。所有案例均为教学插图,用于说明方法论原则,而非真实研究数据或官方评分标准。
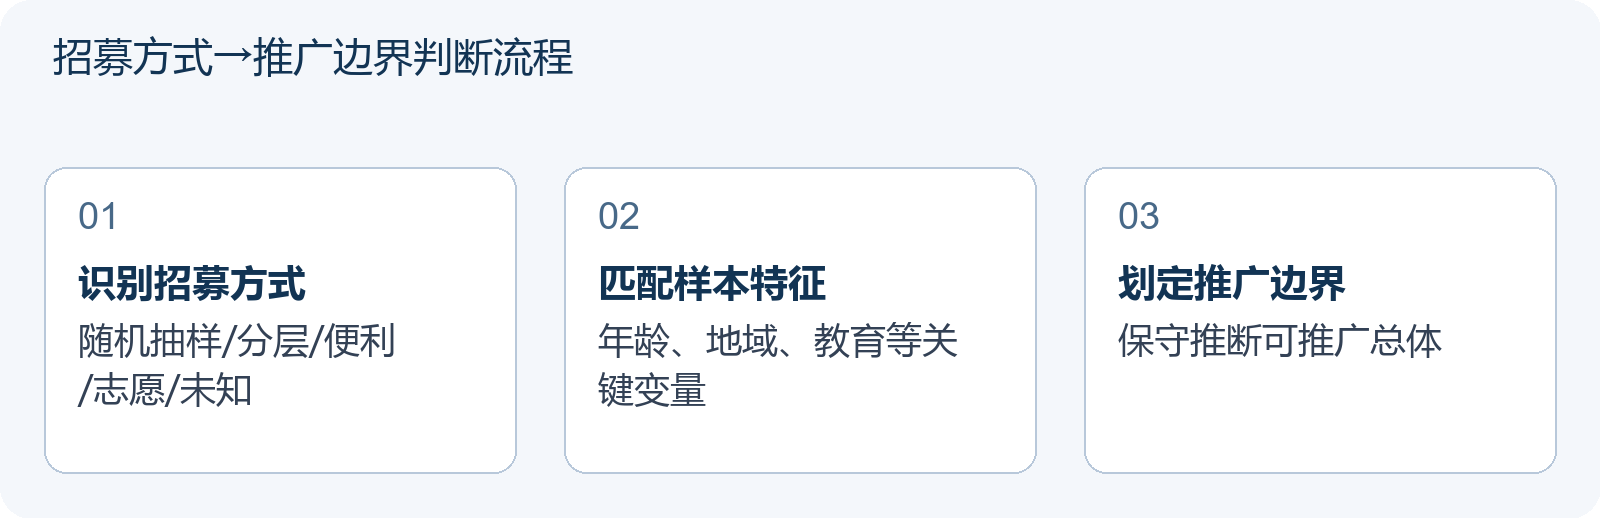
核心判断框架:招募方式→样本特征→可推广总体
在IPsyO的考试语境下,判断研究结论能推广到谁,需要回答三个层次的问题:
- 样本是怎么来的? 这决定了样本与总体之间的初始关系。
- 样本与目标群体在关键特征上是否匹配? 不匹配即存在抽样偏差。
- 结论的推广是否需要跨越「因果」与「相关」的界限? 实验研究与观察研究的推广逻辑不同。
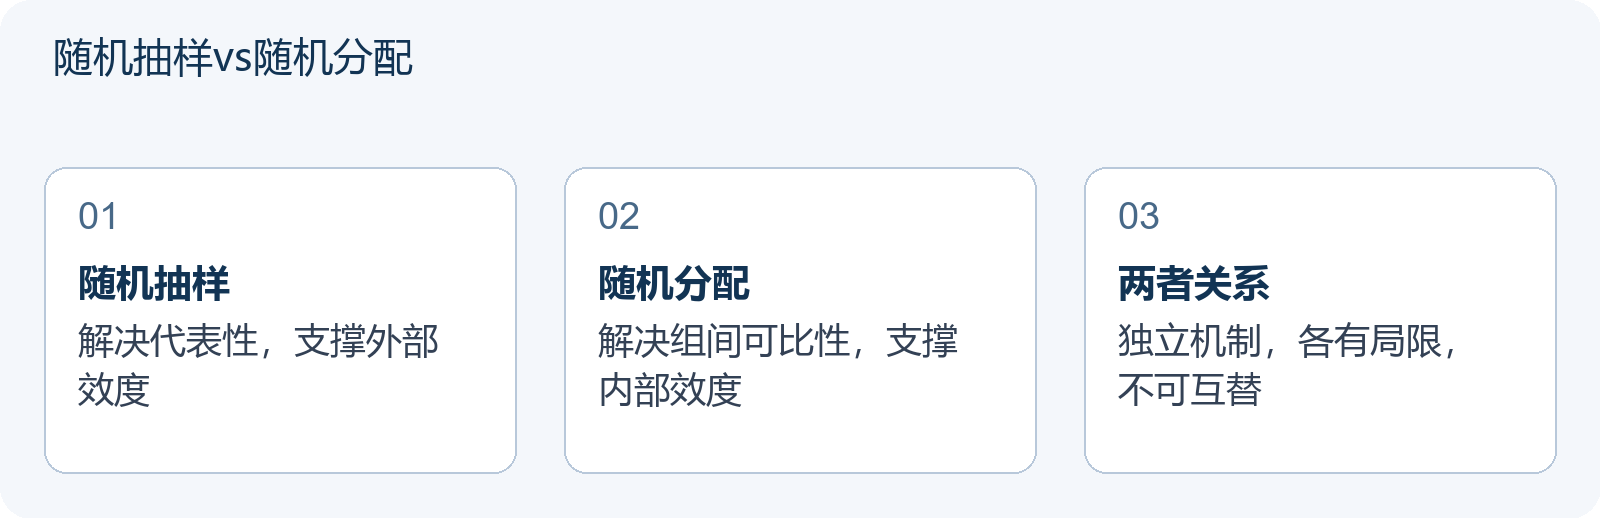
需要特别注意的是,随机抽样(random sampling)解决的是「代表性」问题,随机分配(random assignment)解决的是「组间可比性」问题。一个研究可以有随机分配但没有随机抽样(如实验室实验),也可以有随机抽样但没有随机分配(如调查研究)。混淆这两者,是IPsyO材料题中最常见的失分点之一。此外,即使存在随机分配,流失(attrition)、不依从(non-compliance)、测量误差、执行偏差等因素仍可能威胁结论的可靠性;随机抽样也需要考虑抽样框覆盖、无应答率和权重调整等问题,并非有了「随机」二字就自动保证代表性。
教学案例一:校园招募的睡眠干预研究——为何结论不能推广到上班族?
教学插图背景: 某大学心理学系招募了120名本科生,通过校园海报和课程学分激励参与。研究采用随机分配,将学生分为两组:实验组接受为期两周的睡眠卫生干预,对照组维持日常作息。结果显示实验组的睡眠质量评分显著高于对照组(p < 0.05)。
问题: 该结论能推广到哪个群体?
逐步分析:
第一步:识别招募方式与样本特征。 招募渠道是校园海报和课程学分激励,这意味着样本存在自我选择(self-selection)——只有对学分有需求或对该研究感兴趣的学生才会参与。样本的隐含特征包括:年龄集中在18-22岁、受教育程度为大学本科在读、生活规律受学期制影响、可能缺乏全职工作压力。
第二步:检验样本与目标群体的匹配度。 假设选项中出现「全职上班族」,需要判断关键特征是否匹配。上班族的年龄分布更广(22-60岁)、面临的工作压力源与学生不同(KPI考核而非期末考试)、作息受通勤约束而非课程表约束。这些差异构成了系统性偏差,而非随机误差。
第三步:区分因果内部效度与外部效度。 该研究有随机分配,因此「睡眠干预→睡眠质量改善」的因果关系在该样本内部的组间比较中是成立的。但随机分配保证的是分配机制下的可比性,不能自动解决外部效度问题——它不保证样本能代表任何更大的总体。若存在高流失率、干预执行不一致或测量工具偏倚,即使随机分配,因果推断仍可能受威胁。
结论: 该研究结论最合理的推广范围是「与该大学本科生特征相似的学生群体」,而非泛泛的「成年人」或特定的「上班族」。选项中若出现「所有大学生」也需谨慎,因为不同国家、不同类型高校的学生在作息规律上可能存在差异。便利样本不能自动推广到同类学校人群。
教学案例二:社区分层抽样的健康行为调查——为何结论可以推广到全市居民?
教学插图背景: 某市公共卫生部门采用分层随机抽样,从全市12个行政区中按比例抽取3000名18-65岁居民,进行访谈调查体育锻炼频率与主观幸福感的关系。结果显示两者呈显著正相关(r = 0.32, p < 0.001)。
问题: 该结论能推广到哪个群体?
逐步分析:
第一步:识别招募方式与样本特征。 分层随机抽样(stratified random sampling)按行政区比例抽取,这意味着样本在地理分布上与全市人口结构一致。年龄范围明确限定为18-65岁,排除了未成年人和高龄老人。但需注意:分层随机抽样仍需考虑抽样框是否覆盖全部目标人群、无应答者是否与应答者存在系统差异、以及各层是否需要权重调整。
第二步:检验样本与目标群体的匹配度。 研究目标总体是「该市18-65岁居民」,抽样框架覆盖了全市12个行政区且按比例分层,样本量3000对于推断总体参数而言较为充分。关键人口学特征(年龄、区域分布)与总体一致。
第三步:注意相关研究的固有限制。 该研究是观察性调查而非实验,因此只能建立相关关系,不能推断因果。但题目问的是「推广」而非「因果」,所以外部效度的判断焦点在于样本代表性而非内部效度。r = 0.32 的数值本身需要结合置信区间解读,但材料题通常不要求计算,只需理解其相关性质。
结论: 该研究结论可以合理推广到「该市18-65岁居民」。若选项中出现「全国居民」则过度推广,因为不同城市在经济发展水平、气候条件、公共设施等方面可能存在差异。
对比诊断:两个教学案例的关键差异
| 维度 | 教学案例一(校园招募实验) | 教学案例二(社区分层抽样调查) |
|---|---|---|
| 研究设计 | 实验研究(随机分配) | 观察研究(分层随机抽样) |
| 招募方式 | 便利招募+自我选择 | 分层随机抽样 |
| 样本来源 | 单一大学校园 | 全市12个行政区 |
| 核心偏差风险 | 年龄、教育、生活方式偏差 | 抽样框覆盖、无应答、权重 |
| 可推广范围 | 同类大学生群体 | 该市18-65岁居民 |
| IPsyO常见陷阱 | 误将「随机分配」当作「随机抽样」 | 误将「相关」当作「因果」 |
这两个教学案例的对比揭示了一个核心原则:判断推广范围时,必须同时关注「样本如何产生」和「结论是什么类型」。实验研究即使内部效度良好,也可能因抽样方式而限制外部效度;观察研究即使建立了广泛的相关,也不能跨越到因果推断。
常见变体:当招募方式描述模糊时怎么办
IPsyO材料题有时会故意模糊处理招募细节,例如仅写「招募了100名参与者」。此时需要依据最小信息做出最保守的判断:
- 未说明随机抽样程序时,不能假设样本具有代表性。 代表性需要设计支持,而非默认成立。
- 「志愿者」或「自愿参与」意味着存在自我选择——愿意参与研究的人在某些心理特质上可能与非参与者不同,但具体差异方向不可臆断。
- 未说明抽样框架时,推广边界应保守划定。 研究者从何处、如何接触潜在被试,决定了样本的边界;信息缺失时,不可自动归类为「方便抽样」,应标记为「未知」并谨慎推断。
从诊断到行动:下一步该练什么
如果你在模拟练习中发现自己在「推广判断」类题目上频繁出错,建议按以下顺序排查:
- 第一层:概念混淆。 能否清晰区分随机抽样与随机分配?能否识别自我选择偏差、便利抽样等具体类型?
- 第二层:信息提取。 能否在冗长的材料描述中快速定位招募方式、样本量、抽样框架三个关键信息?
- 第三层:选项辨析。 能否识别「过度推广」(样本特征不支持)与「推广不足」(过于保守)两种错误方向?
针对第三层的训练,建议收集IPsyO历年材料题中涉及外部效度的选项,专门制作一个「推广范围判断」的错题本,标注每个选项的错误类型。这种针对性训练比泛泛刷题更能提升准确率。
相关阅读与延伸
抽样偏差与外部效度的讨论,与IPsyO中研究方法论的其他主题紧密相关。例如,IPsyO相关与因果:从研究结果到结论之间还缺哪一步深入分析了相关研究向因果推断跃迁的逻辑条件;IPsyO研究提案:操作性定义如何把抽象概念变成可测指标则讨论了研究设计前期如何减少后续推广时的概念模糊性。此外,IPsyO实验设计:区分操纵变量、测量变量与混淆变量中的变量控制思路,也是理解实验研究内部效度与外部效度张力关系的基础。
对于计划参加2027年IPsyO的学生,理解抽样偏差不仅是应对材料客观题的需要,更是撰写研究提案(Module B)时设计样本方案、预判研究局限性的基本功。在7分钟视频提案中,明确说明样本来源及其局限性,是评审考察研究严谨性的重要维度。
常见问题
IPsyO考试中,看到「随机」两个字就能推广到所有人吗?
不能。必须区分「随机抽样」和「随机分配」。随机分配解决的是实验组与对照组在分配机制下的可比性问题(内部效度),但不自动保证样本能代表更大总体,且流失、不依从、测量误差等仍可能威胁结论。只有具备明确抽样框和随机抽样程序,才能为推广提供依据。
如果研究只在单一学校进行,但样本量很大,能推广到全国学生吗?
不能仅凭样本量判断。样本量影响的是估计精度,而抽样框架决定的是估计无偏性。单一学校的研究无论样本多大,都存在系统性偏差风险,最多只能推广到同类学校学生。便利样本不能自动推广。
IPsyO Module B的研究提案需要讨论抽样偏差吗?
需要。在7分钟研究提案视频中,明确说明计划招募的样本来源、可能的抽样偏差及其对结论推广的限制,是评审考察研究严谨性的重要方面。这体现了研究者对方法局限性的自觉认识。