读不懂图和数字,材料题就只能猜:IPsyO 里的图表判读与统计结果解读(2026)
材料题给的是研究结果,而研究结果的默认语言是图和统计数字——读不懂图,知识背得再熟也只能靠选项猜。很多学生把失分归因于「这个知识点没学到」,但把错题一道道摊开看,真正的断点常常在更前面一步:那张柱状图的误差棒代表什么、那行括号里的数字在说什么,从来没有人正式教过。
一、为什么「读图」是一项独立能力,而不是知识的附属品
2026 赛季官方公布的决赛赛制里,模块 A 是 120 分钟的材料客观题。「材料客观题」这五个字的重点在前两个字:题目先给一段研究材料,再问问题。而心理学的研究材料,绝大多数不会用一段散文告诉你「A 组比 B 组高」,它会给你一张图、一个表,或者一行像 t(58) = 2.41, p = .019 这样的统计报告。
这就带来一个反直觉的现象:知识和读图是两条独立的能力线。一个把六大领域概念背得很扎实的学生,完全可能在一张画着两条折线的图前卡住;反过来,读图熟练的学生即使理论记得模糊,也常能从图形本身推出方向。我们在带教里反复观察到这一点——学生自评的错因是「不熟」,但让他复述那张图在说什么,往往复述不出来。
好消息是,这一块相对容易集中突破:图的种类有限,陷阱也有限,据我方教学团队观察,集中练一段时间通常见效较快(因人而异)。如果你还不清楚赛事整体结构,可以先看 IPsyO 是什么 里的赛制部分,再回到这里。具体题型分布与考查比重以官方公布为准。
二、四类图,各自回答的是完全不同的问题
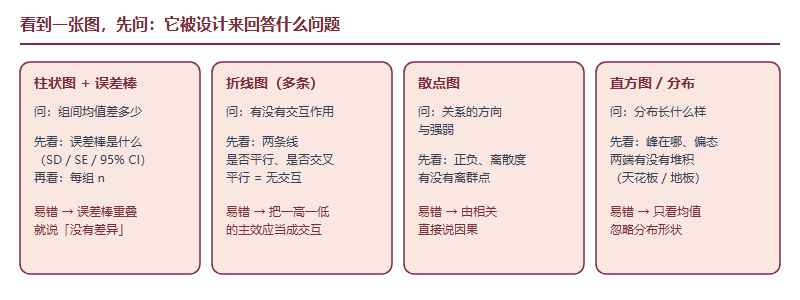
看到一张图,第一件事不是找数字,而是先判断这张图被设计来回答什么问题。问题类型定了,该看哪里也就定了。
| 图的类型 | 它回答的问题 | 先看什么 | 最常见的读错 |
|---|---|---|---|
| 柱状图(带误差棒) | 两组或多组的均值差多少 | 误差棒代表 SD、SE 还是 95% 置信区间;每组 n 是多少 | 看到误差棒重叠就断定「两组没差异」 |
| 折线图(两条以上) | 一个变量的效应是否随另一个变量改变(交互作用) | 两条线是否平行;是否交叉 | 把「两条线整体一高一低」的主效应说成交互作用 |
| 散点图 | 两个连续变量之间关系的方向与强弱 | 方向(正/负)、点的离散程度、有没有离群点 | 由相关直接推因果;被一两个极端点带偏 |
| 直方图 / 频数分布 | 数据的分布形状,是否堆在极端 | 峰在哪、是否偏态、两端有没有堆积 | 只盯均值,忽略天花板效应或地板效应 |
三、五个坐标轴与误差棒陷阱
- 纵轴被截断。y 轴不从 0 开始时,很小的差异会被视觉放大。第一眼先确认起点,以及量表本身的范围(一个 1–7 分量表上 0.3 分的差,和百分制上 30 分的差不是一回事)。
- 误差棒到底是什么。标准差(SD)描述的是个体之间有多分散;标准误(SE)和 95% 置信区间描述的是均值本身有多不确定。同一份数据,画 SD 的棒子会明显比画 SE 的长。图注里通常会写明,务必先读图注再下判断。
- 重叠 ≠ 不显著。误差棒重叠不代表统计上一定没差异,不重叠也不代表一定有差异——这取决于画的是哪种误差棒、样本量多少。这是材料题里最值得警惕的一步过度推断。
- 样本量藏在别处。n 往往写在图注、表格脚注或方法部分。n = 18 和 n = 1800 画出来的同一张图,可推的结论强度完全不同。
- 均值掩盖分布。两组均值可以完全相同,而一组高度集中、另一组两极分化。凡是题目问「这个结论能推广到所有人吗」,答案的线索通常就在分布里。
四、统计结果里的四个数字,各管一件事
材料里出现一串统计量时,不必被符号吓住。真正需要分清的只有四个数字,而且它们回答的是四个不同的问题:
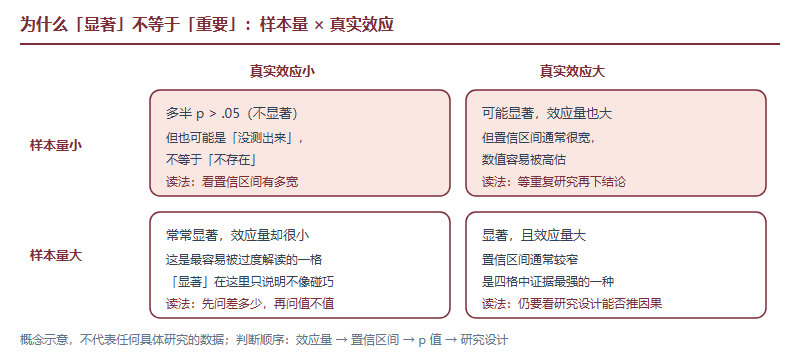
- p 值——回答「这像不像是碰巧」。它是在「不存在真实效应」这一假设下,得到当前这么极端结果的概率。它不告诉你效应有多大,也不告诉你结论有多重要。
- 效应量(如 Cohen's d、相关系数 r)——回答「差多少」。同样标着「显著」,d = 0.15 和 d = 0.90 的现实意义天差地别。
- 置信区间——回答「有多准」。区间越窄,估计越精确;一个又宽又勉强不跨过 0 的区间,说明证据其实很弱。
- 样本量 n——回答「凭多少人说的」。n 足够大时,非常小的差异也会「显著」;n 很小时,真实存在的效应也可能测不出来。
把这四句连起来,就是一条可以带进考场的顺序:先看效应量与置信区间,再看 p 值。习惯这个顺序后,「统计显著因此非常重要」这类干扰选项会自己浮出来。
五、一段材料的四步读法,以及怎么练
把上面的内容压缩成考场上可执行的四步:
- 第一步,先读题干问什么。是问差异、问关系,还是问机制解释?问题类型决定你要在图里找什么,能省下大量无效浏览。
- 第二步,读图注与坐标轴。变量是什么、单位是什么、误差棒是什么、n 是多少。这一步花 20 秒,能挡掉大部分低级失分。
- 第三步,说出方向与量级。用一句话概括:谁高谁低、差多少、关系是正是负、强还是弱。说不出这句话,就不要看选项。
- 第四步,才回到知识。这个结果支持哪个理论、和哪个概念冲突;以及关键一问——这个设计能不能推因果(有没有随机分配、有没有对照)。
训练方法很朴素:先把选项遮住,只做第二、三步,逼自己用一句话复述图在说什么,再看选项。一天两三张图,坚持一段时间通常能感觉到差别(据我方教学团队观察,因人而异)。想把这项训练排进整体节奏,可以参考 资格赛冲刺指南 里的时间分配思路;如果还在判断这项投入值不值得,IPsyO 含金量分析 里对能力迁移的部分可以一并看。
读图和读统计结果,是心理学、生物、经济、社会科学论文共用的一套语言。这项能力练出来之后不会随赛季结束而作废——它会用在校内研究性课程、大学入门统计课,以及任何需要判断「这条结论靠不靠谱」的场合。
常见问题(FAQ)
Q:孩子数学一般,看到统计符号就发怵,还能练这一块吗?
能,而且这一块恰恰不依赖计算能力。材料题要的是判读而不是运算:认出这个数字在回答哪个问题、方向对不对、能不能推因果。全部要背的量级感其实很少——知道效应量有大小之分、置信区间越窄越准、n 越大越容易显著,就已经能应付大部分判断。真正卡人的是术语的中英对应,而不是数学。
Q:材料题里一定会考图表吗?
官方公布的是模块 A 为 120 分钟的材料客观题,具体题型构成与图表所占比重以官方为准,我们不做数量上的承诺。但从材料题的定义出发可以合理推断:研究材料本身就以图和统计报告为主要呈现方式,读图能力属于「不一定单独考,但几乎处处用得上」的底层能力,练了不会浪费。
Q:网上找的图表练习材料,怎么判断适不适合用?
看三件事:有没有完整图注(变量、单位、误差棒含义、n)、有没有交代研究设计(是否随机分配)、结论是不是超出了数据能支持的范围。一张连图注都不全的图,练不出判读能力,反而容易养成看形状猜结论的习惯。教科书和正式期刊论文里的图,通常是更好的练习材料。
Q:家长能怎么帮忙?
不需要懂统计也能帮上忙:让孩子把一张图讲给你听,用一句话说清「谁比谁高、高多少、这能说明什么、不能说明什么」。讲不清楚的地方,就是他真正的薄弱点。这个方法同时也是很好的检索练习——被要求复述比被要求重看一遍有效得多。
本文由 IPsyO 国际心理学奥赛内容编辑部发布,由翰林教育为中国国际学校学生运营。赛事规则由主办方制定并逐年调整,报名、资格、赛程、题型构成与考纲范围请以 IPsyO 官方页面 / APA 公布的信息为准;文中的图示与数字为原理说明,不代表任何具体研究的数据。如发现事实错误,我们将在 7 个工作日内更正。