IPsyO 效应量与样本量:材料题里「统计显著」为什么可能是小结果(含教学示例)
在 IPsyO 研究方法材料题里,看到结果写着 significant,最安全的读法不是「效果很强」,而是「在这项研究的数据里,结果不太像纯随机波动」。它不自动说明效应大、因果成立或可推广到所有人。2026 赛季的备考笔记也把 Research Methods 描述为贯穿全卷的能力,涉及 operational definition、confounding、validity、effect size、alternative explanations 等;同一笔记还指出,2026 年更强调「是否理解、应用、据证据判断」,干扰项常见半对半错、过度推论与因果化。因此,材料题真正要判断的是:这个结论有没有越过证据边界。本文为备考教学解读,不是官方评分说明;所有示例均为假设性教学示例,不是官方题目。
一、先分清:p 值、效应量、样本量各管什么
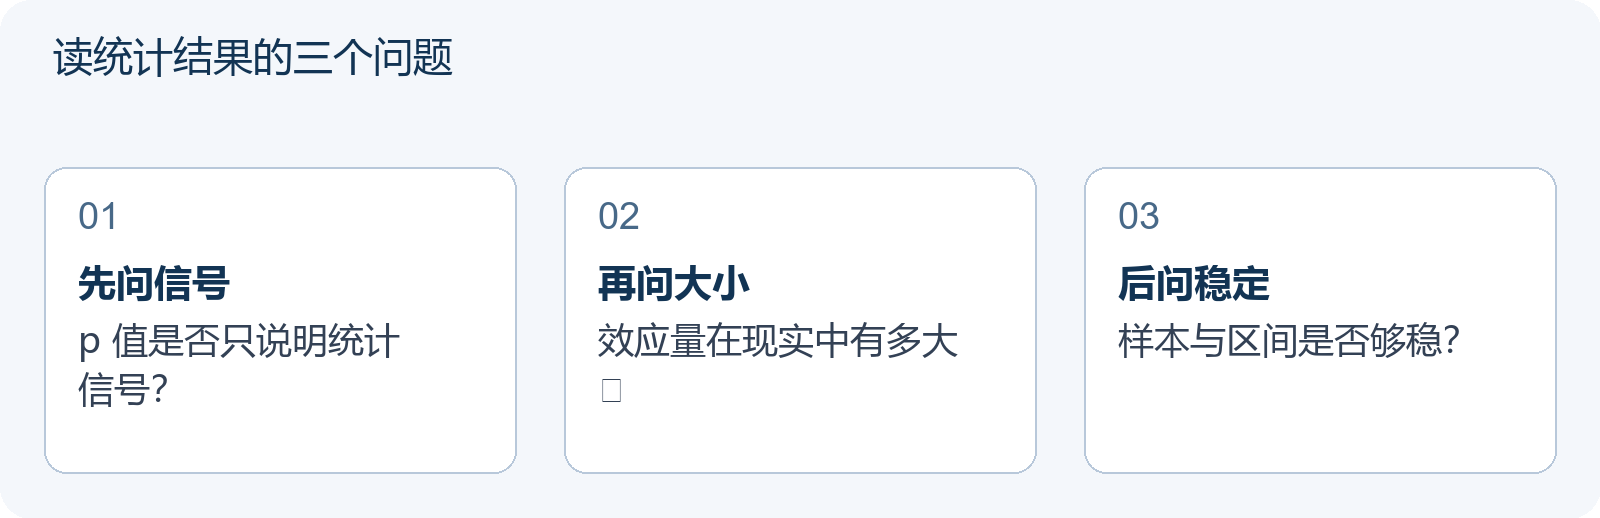
很多失分不是不会算,而是把三个不同问题混成一个。p 值回答「有没有统计信号」;效应量回答「信号有多大」;样本量影响「估计有多稳」。三者不能互相替代。
| 指标 | 主要回答 | 不能回答 | 材料题常见误读 |
|---|---|---|---|
| p 值 | 若原假设成立,出现当前或更极端数据的概率 | 效应大小、因果、可推广性 | 显著=效果强 |
| 效应量 | 差异或关联在标准化、实际单位中的幅度 | 结果是否偶然、样本是否有代表性 | 大效应=已被证明 |
| 样本量 | 估计的精度与稳定性 | 效应大小、抽样偏差、设计质量 | 样本大=适用于所有人 |
还要记住,p 值不是「原假设为真的概率」。p=0.03 不表示「结论有 3% 概率是错的」,也不表示「有 97% 概率正确」。它只是在某个原假设模型下,数据有多不寻常。效应量也不是天然「大就好」:差异是否重要,要看量表、情境和后果。
二、显著但效应小:为什么不能选「效果很强」
大样本会让很小的差异也显得「不像偶然」。这是材料题里最容易被忽略的一类。下面是教学示例一,不是官方题目。
教学示例一:假设一项干预研究把学生随机分为两组,每组 n=1000,前后测改善分数的标准差约为 10。干预组平均改善 71.5 分,对照组平均改善 70.0 分,差值为 1.5 分。为便于手算,假设两组独立、标准差相同,用近似方法:合并标准差取 10,标准化均值差 d=1.5÷10=0.15;差值标准误约为 10×√(1/1000+1/1000)=0.447;z≈1.5÷0.447≈3.35,双侧 p≈0.0008;95% 置信区间约为 1.5±1.96×0.447,即 [0.62, 2.38]。
这组数据可以支持「在这个样本中,干预组平均改善略高,且统计上可区别于零」;但不能支持「干预效果很强」。1.5 分相对 10 分的标准差只有 0.15 个标准差,是否具有现实意义还要看量表,但绝不足以单独推出强效果。材料题若把「显著」写成「效果强」「大幅提升」「足以改变教学安排」,就是越界。正确选项应保留「小幅度」「平均差异」「在该样本中」等限定。
三、大效应但样本小:为什么结论可能不稳
小样本不一定错,但点估计容易不稳定。一个很大的效应量,可能伴随很宽的置信区间;它值得继续验证,不等于已经可以推广。下面是教学示例二,不是官方题目。
教学示例二:假设两组各 n=10,干预组比对照组平均高 8 分,两组标准差均约为 8。标准化均值差 d=8÷8=1.0,看起来是大效应。差值标准误约为 8×√(1/10+1/10)≈3.58;t≈8÷3.58≈2.24,df=18,双侧 p≈0.038;95% 置信区间约为 8±2.101×3.58,即 [0.48, 15.52]。
这里 p 小于 0.05,点估计也大,但置信区间从接近零到很大的差异都相容。材料题若写「已证明该干预普遍有效」「可推广到所有学校」,就把「一次小样本研究出现大估计」误当成了「稳定、可推广的结论」。更准确的表述是:结果提示可能存在较大效应,但样本小、估计不稳,需要更大样本和重复验证;在未说明抽样代表性的情况下,也不能推到所有学生。
四、材料题里最该警惕的四种越界
据《2026 IPsyO 心理学奥赛考情与备考笔记》(2026),论文专项题约 40 题(5 篇论文×8 题),考查 research question、hypothesis、variables、findings、interpretation、limitation 等;这类题尤其容易把「结果」和「解释」混在一起。读选项时,先圈出结论动词和范围词。
- 显著→效果强:把统计信号当成实际重要性。应追问效应量和实际单位。
- 显著→因果:如果设计不是随机实验,或存在混淆变量,就不能仅凭显著推因果。相关与因果的缺口可参考IPsyO相关与因果:从研究结果到结论之间还缺哪一步。
- 样本大→普遍适用:大样本只提高精度,不自动修复抽样偏差。谁能被推广,要看招募方式和样本构成,可参考IPsyO抽样偏差:从招募方式判断研究结论能推广到谁。
- 效应大→结论稳:小样本的大效应可能区间很宽;应看置信区间、重复验证和设计质量。
五、把两个示例放进选项里:怎样改写才准确
教学示例一里,错误选项常写成「干预显著,说明效果很强」。更准确的改写是:「在该大样本中,干预组平均改善略高,差异统计上可区别于零,但标准化效应较小,实际意义需结合量表判断。」这里保留了显著性,却没有把显著性升级为强度。
教学示例二里,错误选项常写成「大效应且显著,说明可推广」。更准确的改写是:「该小样本研究观察到较大点估计,但置信区间较宽,结论应视为初步证据,需更大样本与重复研究。」注意,这不是说小样本研究没有价值,而是说它的证据强度有限。材料题选「最准确」,不是选「听起来最积极」。
如果题目给的是图表,先确认横轴、纵轴、组别和误差线含义;图表判读的基础问题可先看读不懂图和数字,材料题就只能猜:IPsyO 里的图表判读与统计结果解读(2026)。但图表读对之后,仍要回到同一个判断:结论有没有超过数据能支持的范围。
六、结论强度三问:材料题现场可用的顺序
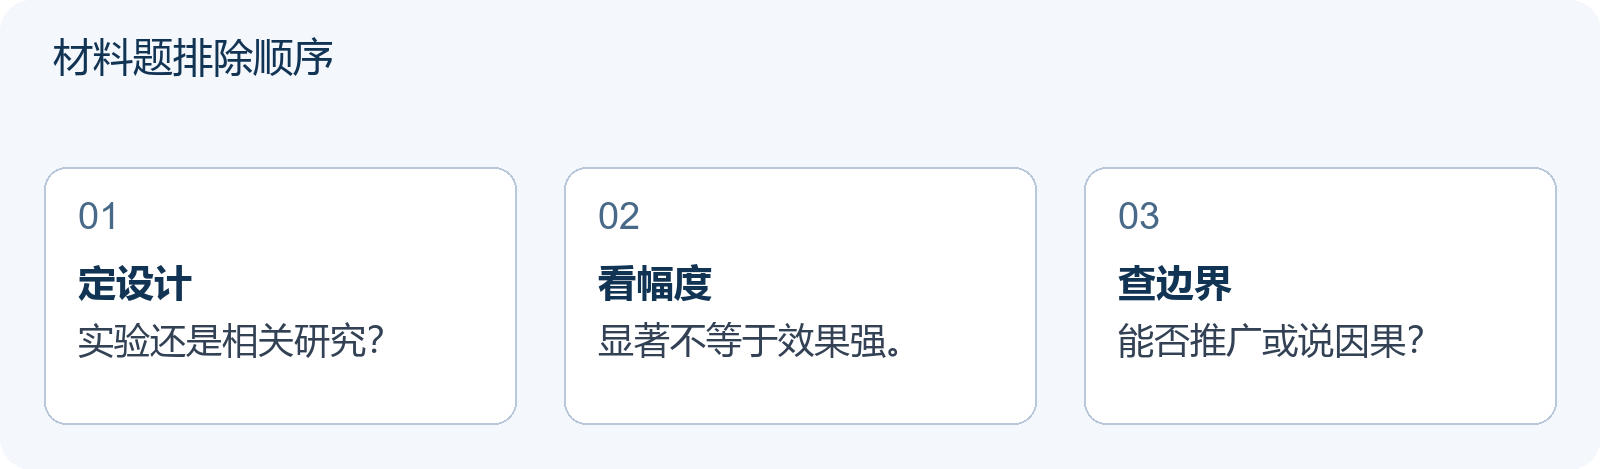
第一问,设计是什么?是随机实验、准实验还是相关研究?有没有混淆变量?如果题干写「导致」「证明」,先检查设计是否支持因果。没有随机分配或充分控制时,最多说「相关」「伴随」「提示」。
第二问,效应量多大?不要只看 p 值。看差异的实际单位,也看标准化效应量。大样本里的小差异可以显著;小样本里的大差异可以显著但很不稳。效应量小不等于「没差异」,但通常不支持「很强」「大幅」。
第三问,估计有多稳、能推给谁?看样本量、置信区间、抽样方式。样本小则区间宽;样本偏则推广范围窄。若题干从「本样本」跳到「所有学生」「所有学校」,要检查是否缺少代表性证据。
七、四步排除表:把「显著」放回证据链
| 步骤 | 你要问 | 若答案是否定 | 选项处理 |
|---|---|---|---|
| 定设计 | 能否支持因果? | 不能 | 排除「导致」「证明」类 |
| 看幅度 | 效应量是否支持「强」? | 不支持 | 改为「小幅」「有限」 |
| 查稳定 | 样本与区间是否够稳? | 不够稳 | 保留「初步」「需重复」 |
| 查范围 | 样本能推到谁? | 范围不明 | 排除「所有人」「普遍」 |
这个表也适用于检查自己写的解释。每次看到「显著」,在旁边写两个词:效应量?样本?如果两个都答不上来,就不要选强度很高的结论。
八、备考建议:把统计词变成判断题
练习时不要只问「这个结果显不显著」,而要改写结论句。可以拿一段材料做三次改写:第一次只写「在该样本中观察到了什么」;第二次补上「效应量大致多大」;第三次补上「能否推广、能否说因果」。三次都写完,再对照选项,通常能看出哪个选项多了半句。
如果错题集中在「读得出数字但判断不了结论」,可以先用样卷按模块统计正确率,把问题分成概念不清与证据判断不稳两类。复习顺序建议是:先分清 p 值、效应量、样本量的分工;再用两个教学示例练习改写;最后把「显著」「大样本」「大效应」分别与「强度」「精度」「可推广性」拆开。这样遇到「显著但小结果」或「大效应但小样本」时,就不会把统计信号误当成强结论。
一般活动背景信息可参见赛事背景资料。
常见问题
显著(significant)是不是就说明效应很大?
不是。显著只说明在当前原假设模型下,数据不太像偶然波动;效应大小要看效应量和实际单位。大样本中很小的差异也可能显著,材料题不能把显著直接改写成效果很强。
样本量小但效应量大,能不能说结论很强?
不能直接说强。小样本的大效应可能是重要线索,但点估计容易不稳,置信区间可能很宽。更准确的表述是初步证据,需要更大样本、重复验证和检查抽样代表性。
材料题里看到 p<0.05 应该先做什么?
先看设计和结论词。若是相关研究,不要选因果表述;再看效应量是否支持强度;最后看样本与区间是否支持推广。把显著、效应量、样本量分开判断,再选限定最准确的选项。